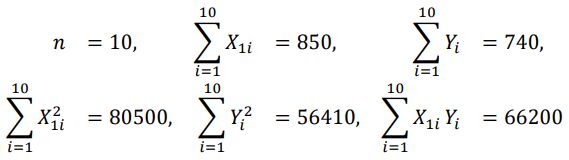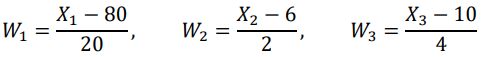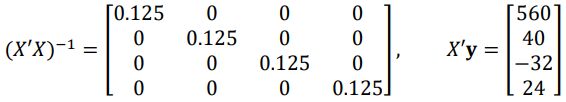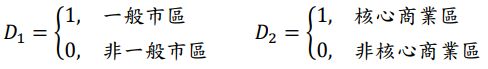所屬科目:高考/三級◆抽樣方法與迴歸分析
(一)市政府先以每千人每月線上申辦件數X1作為自變數,解釋民眾公共服務滿意度。建立簡單線性迴歸模型:\(Y_i = \beta_0 + \beta_1 X_{1i} + \varepsilon_i,\) \(i = 1, 2, ..., 10\)其中,誤差項相互獨立,且服從常態分配:\( \varepsilon_i \sim N(0, \sigma^2) \)已知 10 個行政區的摘要統計量如下:請以最小平方法(least squares method)求出與的估計值,寫出配適後的簡單線性迴歸模型,並計算判定係數,說明其意義。(15 分)
(二)延續第(一)題的簡單線性迴歸模型,請建立變異數分析表,並在顯著水準 α= 0.05下檢定迴歸模型是否顯著。已知臨界值為:F0.05(1,8) = 5.32 (12 分)
(三)市政府進一步同時考慮線上申辦件數、平均案件處理天數與服務據點數對滿意度的影響,建立複迴歸模型:\[Y_i = \beta_0 + \beta_1 W_{1i} + \beta_2 W_{2i} + \beta_3 W_{3i} + \varepsilon_i\]其中:令設計矩陣(design matrix)為X,反應變數向量(response vector)為y ,複迴歸模型可表示為:\(y = X\beta + \epsilon\)且已知:請利用最小平方法估計β,寫出複迴歸估計模型,並預測某行政區在X1= 100、X2= 5、X3= 14時的公共服務滿意度。(13 分)
(四)市政府為了解不同類型行政區的公共服務滿意度差異,將行政區分為三類:偏遠地區、一般市區與核心商業區。其中以「偏遠地區」作為基準組,並設定兩個屬性自變數如下:根據資料,估計得到下列迴歸式:\[ \hat{Y} = 46.80 + 0.32X_1 - 1.45X_2 + 5.20D_1 + 10.40D_2 \]請解釋 5.20 與 10.40 兩個迴歸係數的意義。在控制線上申辦件數與平均案件處理天數後,核心商業區的預測滿意度比一般市區高多少分?(10 分)
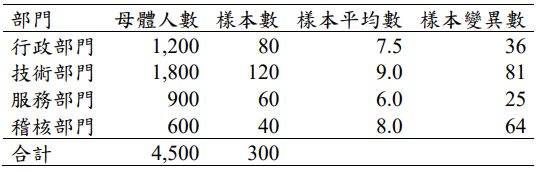
(一)研究團隊完成比例配置抽樣後,得到下列樣本統計量:請估計全機關員工每週使用生成式 AI 協助公務的平均時數,並建立全機關平均使用時數的 95% 信賴區間。
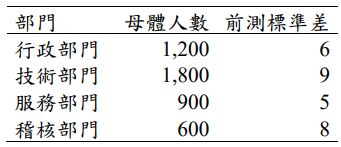
(二)研究團隊在正式抽樣前進行前測,得到各部門員工使用生成式 AI 時數的標準差如下:若總樣本數為 300,請使用 Neyman allocation 計算各部門建議樣本數,並說明配置結果的意義。
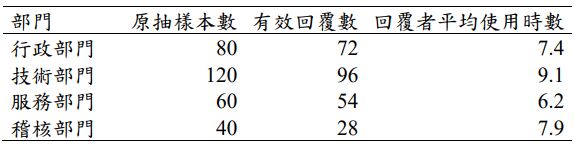
(三)正式調查後,實際回收情況如下:若原本採比例配置,各層基本權重皆為 15,請計算各部門非回覆調整後權重,並估計非回覆調整後全機關員工每週平均使用生成式 AI 協助公務的時數,同時說明若不處理非回覆可能造成的問題。
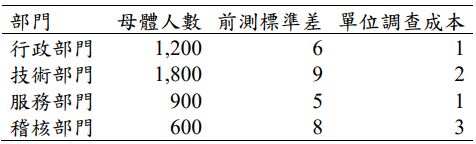
(四)研究團隊發現,不同部門完成一份有效問卷的成本不同,資料如下:若總調查成本限制為 500,請使用成本限制下的最適配置計算各部門建議樣本數,並說明此配置與 Neyman allocation 的差異。
(五)若政府機關希望估計全機關員工每週使用生成式 AI 協助公務的平均時數,並希望在 95% 信心水準下估計誤差不超過 0.5 小時。根據前測 資料,估計全體標準差為 7.5,母體總人數為 4,500。請分別計算不考慮有限母體修正與考慮有限母體修正時所需樣本數;若預估問卷回覆率為 80%,請計算原始應抽樣本數。
 阿摩線上測驗
登入