所屬科目:國營事業◆1.統計學 2.巨量資料概論
1. 關於簡單隨機抽樣(Simple Random Sampling, SRS),下列敘述何者正確? (A)適用於母體個體特徵差異極大的情況 (B)屬於非機率抽樣的一種 (C)母體中每個元素被抽中的機率皆相等 (D)先將母體分群,再從每一群中隨機抽取個體
2. 有關t分配與常態分配的峰態係數,下列敘述何者正確? (A) t分配的峰態係數比較小 (B) t分配的峰態係數比較大 (C)兩分配的峰態係數一樣大 (D)兩分配的峰態係數無法比較
3. 若有一組樣本以美金為單位,現今將之轉換成以新台幣為單位,則下列何者統計量轉換前跟 轉換後相同? (A)變異係數(Coefficient of Variation) (B)平均數(Mean) (C)四分位數(Quartile) (D)標準差(Standard Deviation)
4. 若有一組樣本資料為(4, 8, 10, 14),則其「中位數」為何? (A) 8 (B) 9 (C) 10 (D) 11
5. 某籃球運動員的罰球命中率為70%,若他決定持續罰球,直到命中3球為止,則他在第5次罰 球時剛好達成目標的機率最接近下列何者? (A) 12.10% (B) 18.52% (C) 20.50% (D) 34.30%
6. 6. 關於有限母體校正因子(Finite Population Correction Factor, FPC)之敘述,下列何者有誤? (A) FPC的計算公式通常為 \( \sqrt{(N-n)/(N-1)} \),其中N為母體大小,n為樣本大小 (B) 當採用放回抽樣(Sampling with Replacement)時,無論母體大小為何,皆不需乘以FPC (C) 當抽樣比例(n/N)不大於5%時,FPC接近1,實務上可省略不乘 (D) 乘上FPC後,樣本平均數的標準誤會比未乘之前變大
7. 若資料中存在極端值,下列何種分散程度指標最具強健性(不受極端值干擾)? (A)全距 (B)變異數 (C)四分位距(IQR) (D)標準差
8. 關於估計全校學生身高之變異數,若已知身高資料服從常態分配,則可根據下列何種抽樣分 配,建立母體變異數的95%信賴區間? (A) N(0,1) (B) t分配 (C) Chi-Square分配 (D) F分配
9. 某罕見疾病在人群中的盛行率為0.1%,有1種篩檢試劑,其患病者呈陽性為95%,未患病者呈陽 性為5%,若1人檢驗結果為陽性,則實際患病的機率最接近下列何者? (A) 1.86% (B) 5.00% (C) 50.00% (D) 95.00%
10. 若X與Y為相互獨立的隨機變數,已知Var(X) = 3,Var(Y) = 2,則Var(2X−3Y+5)的值為何? (A) 12 (B) 17 (C) 30 (D) 35
11. 某工廠生產的晶片不良率為1%,若隨機抽取200個晶片進行檢測,則恰好有2個瑕疵品之機率最接近下列何者? (A) 27.07% (B) 32.21% (C) 35.61% (D) 40.50%
12. 關於統計檢定力(Statistical Power)的觀念,下列敘述何者有誤? (A)檢定力定義為當對立假設 \( H_1 \) 為真時,能夠正確拒絕 \( H_0 \) 的機率 (B)檢定力的數學公式為 \( 1 - \beta \) (C)效果量(Effect Size)越大,統計檢定力通常越高 (D)顯著水準 \( \alpha \) 設定得越小,統計檢定力就會越高
13. 在一項臨床試驗中,若實驗組與對照組的發病率分別為 \( p_1 = 0.2 \) 與 \( p_2 = 0.1 \),則實驗組相對於對照組的勝算比(Odds Ratio, OR)為何? (A) 0.50 (B) 1.25 (C) 2.00 (D) 2.25
14. 已知某多元線性迴歸模型包含3個自變數,總樣本數為24。若迴歸平方和SSR = 120,殘差平 方和SSE = 80,則檢定整體模型顯著性的F統計量為何? (A) 1.50 (B) 6.67 (C) 10.00 (D) 30.00
15. 關於皮爾森卡方獨立性檢定(Pearson’s Chi-Square Test for lndependence),下列敘述何者有誤? (A)卡方統計量的值恆大於或等於0 (B)若觀察次數與期望次數完全相同,則卡方統計量為0 (C)卡方檢定屬於雙尾檢定(Two-TaiIed Test) (D)自由度越大,卡方分配的形狀越接近常態分配
16. 若隨機變數X的機率分配為P(X = 1) = 0.2,P(X = 2) = 0.5,P(X = 3) = 0.3,則Var(X)為何? (A) 0.07 (B) 0.49 (C) 2.10 (D) 4.90
17. 某資料集的平均數為80,標準差為10,至少有多少百分比的資料會落在60 < X < 100區間? (A) 75% (B) 95% (C) 99.7% (D) 100%
18. 若連續型隨機變數 \( X \) 的累積分配函數(CDF)為 \( F_X(x) \),則隨機變數 \( U = F_X(X) \) 服從下列何種分配? (A) \( Beta(1/2, 1/2) \) (B) \( Exp(0, 1) \) (C) \( N(0, 1) \) (D) \( Uniform(0, 1) \)
19. 假設 \( X_1, ..., X_n \) 為來自於母體平均數為 \( \mu \),母體變異數為 \( \sigma^2 \) 的一組隨機樣本,下列敘述何者有誤? (A) \( \bar{X} = (\sum_{i=1}^{n} X_i)/n \) 是 \( \mu \) 的不偏估計量 (B) \( S^2 = \sum_{i=1}^{n} (X_i - \bar{X})^2 / (n - 1) \) 是 \( \sigma^2 \) 的不偏估計量 (C) \( \bar{X} = (\sum_{i=1}^{n} X_i)/n \) 是 \( \mu \) 的一致估計量 (D) \( S = \sqrt{S^2} \) 是 \( \sigma \) 的不偏估計量
20. 在邏輯斯迴歸(Logistic Regression)模型?????(?) = -1.5 + 0.8X中,當X每增加1個單位時,事件 發生的勝算(Odds)會如何變化? (A)增加0.8個單位 (B)乘以? 0.8倍 (C)增加80%的機率 (D)乘以0.8倍
21.單因子之變異數分析(One-Way ANOVA),虛無假設 \( H_0 \) 為所有組別的母體平均數皆相等 \( (\mu_1 = \mu_2 = \cdots = \mu_k) \)。若檢定結果達到顯著水準並拒絕虛無假設,則下列敘述何者正確? (A)所有組別的母體平均數兩兩都不相等 (B)所有組別的樣本平均數皆不相等 (C)至少有兩組的母體平均數顯著不同 (D)組內變異數大於組間變異數
22. 設隨機變數 \( X \) 及 \( Y \) 服從以下聯合機率密度函數(Joint Probability Density Function),則常數 \( a \) 值為何? \[ f_{X,Y}(x, y) = \begin{cases} ax, & \text{if } 1 \le x \le y \le 2 \\ 0, & \text{otherwise.} \end{cases} \] (A) 1/2 (B) 2/3 (C) 3/2 (D) 4
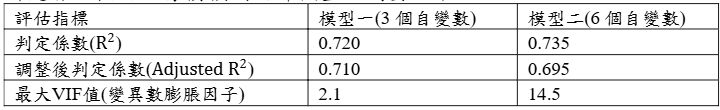
23. 研究者比較兩個房價預測迴歸模型,摘要如下:關於此二模型的判讀與選擇,下列敘述何者最適當?(A)模型二的\( R^2 \)較高,表示模型二的預測能力較好(B)模型二的最大VIF = 14.5 > 10,顯示存在嚴重的多元共線性問題(C)模型二新增的3個變數有效提升了模型的解釋能力,故其Adjusted \( R^2 \)下降屬正常現象(D)模型一的\( R^2 \)較低,代表模型的簡化程度不足
24. 下列何種機率分配具備無記憶性(Memoryless Property)? (A) Bernoulli(p) (B) Gamma(\( \alpha, \beta \)) (C) Beta(\( \alpha, \beta \)) (D) Geometric(p)
25. 針對同一組資料與假說,分別進行雙尾檢定與單尾檢定,並皆將顯著水準設定為α = 0.05。 關於此時兩者的型一錯誤機率,下列敘述何者正確? (A)單尾檢定無法控制型一錯誤 (B)雙尾檢定的型一錯誤機率大於單尾檢定 (C)單尾檢定的型一錯誤機率為0.05,雙尾檢定為0.025 (D)單尾檢定與雙尾檢定的型一錯誤機率皆為0.05
26. 大型語言模型如ChatGPT,其底層所採用的GPT預訓練模型,是基於下列何種神經網路架構發展? (A) Apriori (B) Convolutional Neural Network(CNN) (C) Decision Tree (D) Transformer
27. 採隨機森林(Random Forests)演算法,以自助抽樣後未被抽中參與建樹的資料,用來評估模型 特徵數量的資料集稱為下列何者? (A) Cross-Validation Data (B) K-Fold Data (C) OOB(Out-Of-Bag)資料集 (D) Train-Test Data
28. 支援向量機(Support Vector Machine, SVM)分類器的基本原理,是在維度空間中尋找一個能夠 分割不同類別且滿足下列何種條件的決策超平面? (A)距離原點最短 (B)包含最多訓練數據點 (C)邊距(Margin)最大化 (D)節點分支數量最少
29. 在卷積神經網路(Convolutional Neural Network, CNN)操作過程,主要用於壓縮圖片尺寸以減 少運算空間與參數量的操作,即稱為下列何者? (A)激活(Activation) (B)卷積(Convolution) (C)平坦化(Flatten) (D)池化(Pooling)
30. 商業顧客價值分析中常使用的RFM模型,其英文字母「R」代表意義為下列何者? (A) Rate(利率) (B) Recency(最近一次消費時間) (C) Return(退貨率) (D) Risk(風險評估)
31. 資料湖倉(Data Lakehouse)架構例如:Delta Lake、Apache Iceberg,主要是在資料湖之上加入 下列何種能力? (A)只能存放影像、影音等非結構化資料 (B)取消資料綱要,使資料格式完全自由 (C)支援ACID交易與綱要管理等特性 (D)改以磁帶作為主要且唯一的儲存媒體
32. A量販店以向量記錄會員是否購買甲、乙、丙三項商品(購買 = 1,未購買 = 0)。會員U = (1, 0, 1), 會員V = (1, 1, 0)。若以餘弦相似度(Cosine Similarity) = (U·V)÷(ǁUǁ×ǁVǁ)計算,則U、V會員的相似度 為何? (A) 0 (B) 0.5 (C) 0.71 (D) 1
33. 下列資料儲存單位採由小至大方式排序,下列何者正確? (A) TB < PB < EB < ZB (B) TB < PB < ZB < EB (C) TB < EB < PB < ZB (D) GB < TB < EB < PB
34. 某用電量預測模型對連續3天的預測誤差(實際值-預測值)分別為+2、-2、+4(單位:萬度), 其平均絕對誤差(MAE)與均方誤差(MSE)分別最接近下列何者? (A) 1.33、8 (B) 2.67、8 (C) 2.67、24 (D) 8、2.67
35. 甲公司在偏遠地區布建大量漏水感測器,但當地網路頻寬有限。若在感測端就近即時判斷異 常,將警示與摘要資料回傳雲端,最適合採用下列何種架構? (A)將所有原始資料即時上傳至集中式雲端資料倉儲 (B)以人工定期巡檢並抄錄感測器數值 (C)以單一大型主機集中處理所有感測資料 (D)邊緣運算(Edge Computing)
36. 某文件集共有1,000篇客服紀錄,「停電」一詞出現在其中10篇。某篇紀錄共有100個詞,「停 電」出現5次。若TF = 該詞出現次數÷該文件總詞數,IDF = log₁₀(總文件數÷含該詞之文件數), 則「停電」在該篇紀錄的TF-IDF值為下列何者?(提示:log₁₀100 = 2) (A) 0.05 (B) 0.10 (C) 0.20 (D) 0.50
37. 電商平台比較兩種網頁版面對轉換率的影響,將使用者隨機分為兩組分別呈現,此方法稱為 下列何者? (A)交叉驗證 (B)分層抽樣 (C)資料增強 (D) A/B測試
38. 在關聯式資料庫的ACID特性中,Isolation(隔離性)係指下列何者? (A)交易一旦提交即永久保存 (B)並行執行的交易互不干擾,結果如同循序執行 (C)交易必須全部完成或全部不執行 (D)交易前後資料皆須符合完整性限制
39. NoSQL資料庫常採用BASE原則,其英文字母「E」代表意義為下列何者? (A) Efficiency(效率) (B) Encryption(加密) (C) Eventual Consistency(最終一致性) (D) Exclusive(互斥)
40. 將資料切分為訓練集、驗證集與測試集,驗證集(Validation Set)的主要用途為下列何者? (A)調整超參數與選擇模型 (B)訓練模型參數 (C)最終評估模型泛化能力 (D)儲存原始資料備份
41. 有關K-Means演算法之敘述,下列何者正確? (A)不需事先指定群數k (B)結果可能受初始中心點選擇影響 (C)能有效找出任意形狀的群集 (D)對離群值不敏感
42. DBSCAN演算法的主要特性為下列何者? (A)依據密度分群,可找出任意形狀群集並識別雜訊點 (B)必須事先指定群數 (C)僅適用於球形群集 (D)屬於監督式學習
43. ①資料(Data) ②資訊(Information) ③知識(Knowledge) ④智慧(Wisdom)等 4 項要因,在數據金 字塔模型結構中決策的階層順序,下列何者正確? (A) ①②③④ (B) ④③②① (C) ②①④③ (D) ①④②③
44. 甲公司依據油價走勢、各油庫庫存與運輸成本,以最佳化模型規劃短期各油庫的最適配送量。 此類分析屬於下列何者? (A)描述性分析(Descriptive Analytics) (B)診斷性分析(Diagnostic Analytics) (C)預測性分析(Predictive Analytics) (D)處方性分析(Prescriptive Analytics)
45. 推薦系統中的冷啟動(Cold Start)問題係指下列何者? (A)伺服器開機時間過長 (B)推薦結果重複性過高 (C)新使用者或新商品缺乏歷史互動資料,難以推薦 (D)模型訓練需要GPU
46. 巨量資料分析平台常以Apache Parquet或ORC等欄式儲存(Columnar Storage)格式存放資料,其 最主要優點為何? (A)查詢只讀取所需欄位,且壓縮效率較佳 (B)最適合頻繁進行單筆交易的新增與修改 (C)資料寫入時完全不需要定義任何綱要 (D)可以完全取代線上交易處理(OLTP)資料庫
47. 甲公司透過先進讀表基礎建設(Advanced Metering Infrastructure, AMI)蒐集用戶相關用電資 料,下列何者為其最直接的巨量資料應用? (A)進行負載預測,支援需量反應(Demand Response)方案 (B)即時調整各發電機組的燃料配比 (C)取代變電所保護繼電器(Relay)的跳脫功能 (D)直接量測輸電線路的導線溫度
48. ROC曲線下面積(AUC)等於0.5,代表模型的分類能力為下列何者? (A)與隨機猜測相當 (B)完美分類 (C)完全反向預測 (D)無法計算
49. 時間序列 Autoregressive Integrated Moving Average Model(ARIMA)模型解析資料過程,將時間 規律拆解為三種因素,不包括下列何者? (A)季節變動(Seasonal) (B)空間擴散變動(Spatial Diffusion) (C)長期趨勢(Trend) (D)不規則變動(Random)
50. 隱馬可夫模型(Hidden Markov Model, HMM)相較於一般馬可夫網路,其核心假設與特性為何? (A)假設部分狀態無法直接觀察(隱狀態),需透過可觀察的事實(顯狀態)來進行推論與預測 (B)完全不考量事件發生的前後時間順序 (C)僅能處理純文本資料,無法處理時間序列數據 (D)不需要建立任何狀態轉移機率矩陣
 阿摩線上測驗
登入