所屬科目:研究所、轉學考(插大)◆統計學
1. 在右偏分佈中, (A)中位數等於算術平均值。 (B)中位數小於算術平均值。 (C)中位數大於算術平均值。 (D)以上都不是。
2. 根據經驗法則,如果數據形成鐘形分佈,則觀測值的 百分比將包含在算術平均值附近 1 個 標準差內。 (A) 68.26 (B) 75.00 (C) 88.89 (D) 93.75
3. 對某公司員工的教育背景(大學學歷或非大學學歷)和婚姻狀況(單身或已婚)等問題進行了 調查。600 名員工中,大專學歷 400 人,單身 100 人,單身大學畢業生 60 人。公司員工已婚並 擁有大學學歷的機率為: (A) 0.0667 (B) 0.5667 (C) 0.6667 (D) 0.8333
4. 一家公司有 2 台生產零件的機器。舊機器生產 23% 有缺陷的零件,而新機器僅生產 8%有缺 陷的零件。此外,新機器生產的零件是舊機器的 3 倍。隨機選擇公司生產的零件有缺陷的機 率是多少? (A) 0.078 (B) 0.1175 (C) 0.156 (D) 0.310
5.多重選擇題測試有 30 道題。每問題有 4 個選項。沒有為考試而學習的學生決定隨機回答所有 問題。什麼類型的概率分佈可以用來計算他至少答對 20 道題的機會? (A)二項分佈 (B)泊松分佈 (C)超幾何分佈 (D)以上皆非
6. X 代表下一個學生到達大學圖書館停車場的時間。如果我們知道到達時間的分佈可以用平均為 4 分鐘的指數分佈來建模,求出到達時間超過 10 分鐘的機率下一位學生到達圖書館停車場。 (A) 0.917915 (B) 0.670320 (C) 0.329680 (D) 0.082085
7.抽樣分佈描述了: (A)參數的分佈 (B)統計量的分佈 (C)參數和統計量的分佈 (D)既不是參數也不是統計量的分佈
8.中央極限定理在統計學中很重要,因為: (A)對於較大的樣本數 n,它表示母體近似常態。 (B)對於任何母體,它表示樣本均值的抽樣分佈近似於常態分佈,而與樣本大小無關。 (C)對於較大的樣本數 n,它表示樣本均值的抽樣分佈近似正態分佈,而與母體的形狀無關。 (D)對於任何大小的樣本,它表示樣本均值的抽樣分佈是近似常態。
9. 100 個樣本的平均值的標準誤是 30。為了將平均值的標準誤減少到 15,我們: (A)將樣本數增加到 200 (B)將樣本數增加到 400 (C)將樣本數減少到 50 (D)將樣本數減少到 25
10.假設 μ 的 95% 置信區間為 (1000, 2100)。為了從數據中做出更有用的推論,需要減小信賴區 間的寬度。以下哪項會導致間隔寬度減小? (A)增加樣本量 (B)提高信賴水準 (C)增加母體均值 (D)增加樣本均值
11.以下關於 t 分佈的說法不正確的是? (A)與正態分佈相比,它尾部的面積更大,而中心的面積更少。 (B)當母體標準差已知時,它用於構建母體均值的信賴區間。 (C)它是鐘形和對稱的。 (D)隨著自由度的增加,t 分佈接近常態分佈。
12.假設 µ 的 95% 信賴區間是 (120, 145)。給出“95% 信賴”作為推論的定義。 (A)在重複抽樣中,母體參數將有 95% 的時間落在給定的區間內。 (B)在重複抽樣中,構建的 95% 的區間將包含母體均值。 (C)整個母體中 95% 的觀測值落在給定區間內。 (D)樣本中 95% 的觀測值落在給定區間內。
13.一家大型百貨連鎖店有興趣估算其信用卡客戶在首次訪問該連鎖店在商場的新店時的平均消 費金額。隨機抽取 15 個信用卡帳戶進行分析,結果如下: Xഥ=$50.50 和 S=20。如果消費金 額服從常態分佈,則為其信用卡客戶首次光顧商場中連鎖新店的平均金額構建一個 95% 的信 賴區間。 (A)$50.50 ± $9.09 (B)$50.50 ± $10.12 (C)$50.50 ± $11.00 (D)$50.50 ± $11.08
14.以下哪項是合適的對立假設? (A)母體比例小於 0.65 (B)樣本比例小於 0.65 (C)母體比例不低於 0.65 (D)樣本比例不低於 0.65
15.型 I 錯誤發生於當: (A)你拒絕一個為真的虛無假設 (B)你不拒絕一個為真的虛無假設 (C)你拒絕一個錯誤的虛無假設 (D)你不拒絕一個錯誤的虛無假設
16.你知道一個檢驗的顯著水準(α)是 5%,你可以看出犯型 II 錯誤的機率(β)是: (A)2.5% (B)95% (C)97.5% (D)未知
17.一位企業家正在考慮購買投幣式洗衣機。當前所有者聲稱,在過去 5 年中,平均每日收入為 675 美元,母體標準差為 75 美元。30 天的樣本顯示每日平均收入為 625 美元。如果您要檢 驗每日平均收入為 675 美元的虛無假設,您會使用哪個檢驗? (A)母體均值的 Z 檢定 (B)母體比例的 Z 檢定 (C)母體均值的 t 檢定 (D)母體比例的 t 檢定
18.兩個獨立母體均值之間差異的 t 檢定假設各自的: (A)樣本數相等 (B)樣本變異數 (C)母體大致常態 (D)以上皆是
19.一個強大的女性團體聲稱,男性和女性對性別歧視的態度不同。一組 50 名男性(第 1 組) 和 40 名女性(第 2 組)被問及他們是否認為美國存在性別歧視問題。在被抽樣的人中,11 名 男性和 19 名女性確實認為性別歧視是一個問題。試求本問題的檢定統計量的值。 (A)Z = – 2.55 (B)Z = – 0.85 (C)Z = – 1.05 (D)Z = – 1.20
20.在單一因子 ANOVA 中,如果計算的 F 統計量大於臨界 F 值,您可以: (A)拒絕 H0,因為有證據表明所有均值不同。 (B)拒絕 H0,因為有證據表明並非所有均值都相同。 (C)不拒絕 H0,因為沒有證據表明均值存在差異。 (D)因犯了錯誤而不拒絕 H0。
21.以下哪個模型選擇過程是試圖在不檢查所有可能模型的情況下找到最佳迴歸模型? (A)簡約原則 (B)交叉驗證 (C)逐步迴歸 (D)收集新數據並使用迴歸來驗證模型
22.如果 Durbin-Watson 統計量的值接近 0,違反了線性迴歸哪個假設? (A)誤差項的常態性 (B)誤差項的獨立性 (C)均齊變異性 (D)以上皆非
23.在執行涉及兩個數值變量的迴歸分析時,您假設: (A)X 和 Y 的變異數相等 (B)對於每個 X 值,迴歸線周圍的變異相同的 (C)X 和 Y 是獨立的 (D)以上皆是
24.當我們說簡單的線性迴歸模型在“統計上”有用時,我們是什麼意思? (A)從樣本中計算出的所有統計數據都是有意義的 (B)該模型是 Y 的出色預測器 (C)該模型對預測 Y“實際上”有用 (D)該模型比樣本均值?ത更能預測 Y
25.一位個體經濟學家想要確定公司銷售額如何受到公司的資本和工資支出的影響。她隨機選擇 26 家大公司作為樣本。統計分析發現,公司的資本支出與工資支出存在顯著的反比關係。開發 這種多元迴歸模型的個體經濟學家應該特別關注什麼? (A)誤差項的隨機性 (B)共線性 (C)殘差的常態性 (D)缺失觀察值
二、若 X 為一隨機變數且 \( X \sim N(3,5) \),令 \( Y = e^x \),試求 \( E(Y) \) 及 \( Var(Y) \)? (8 分)
(1) 請分別求出 X 與 Y 的邊際機率密度函數 \( f_1(x) \) 及 \( f_2(y) \).(8 分)
(2)?與?是否獨立?為什麼?(4 分)
(1)當顯著水準a= 5%,會接授或棄卻H0?(5 分)
(2)求此檢定之近似 p-value?(5 分)
五、某主管欲了解金融從業人員的月薪是否能用年資來預測,以作為未來給薪之參考。他收集了 以下 15 筆樣本,每筆包含年資(x:以年為單位)及月薪(Y:以仟元為單位)。試利用這些 資料求其最小平方迴歸線。(10 分) \( \sum_{i=1}^{15} x = 71, \sum_{i=1}^{15} y = 877, \sum_{i=1}^{15} x^2 = 5,041, \sum_{i=1}^{15} y^2 = 769,129, \sum_{i=1}^{15} xy = 62,267 \)年資(?) 月薪(?) 年資(?) 月薪(?) 年資(?) 月薪(?) 5.1 62 7.0 68 2.5 48 7.5 70 3.2 51 3.6 52 1.3 38 9.6 85 6.6 72 2.0 43 3.8 53 5.9 65 6.7 73 1.9 40 4.3 57
(1)\( P(X_1 = 3, X_2 = 5) = ? \)(5 分)
(2)\( P(X_1 = 3, X_2 = 5) = ? \)(5 分)
 阿摩線上測驗
登入
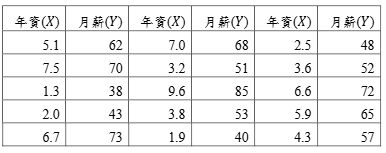 年資(?) 月薪(?) 年資(?) 月薪(?) 年資(?) 月薪(?) 5.1 62 7.0 68 2.5 48 7.5 70 3.2 51 3.6 52 1.3 38 9.6 85 6.6 72 2.0 43 3.8 53 5.9 65 6.7 73 1.9 40 4.3 57